 写真はイメージです Photo:PIXTA
ニュースで耳にする「50年に一度の大雨」。それほど珍しいはずなのに、なぜ各地で毎年のように聞くのだろうか。そもそも観測データが50年にも満たない地点で、「50年に1度」という雨量はどう算出するのか。気象データと統計から、そのカラクリをひもとく。※本稿は、東京大学大気海洋研究所気候システム研究系准教授の今田由紀子『異常気象の科学 猛暑・豪雨・大雪のしくみと将来予測』(講談社)の一部を抜粋・編集したものです。
「50年に1度の大雨」は
どうやって算出するのか
近年、日本では豪雨の報告が後を絶ちません。
過去数年間をさかのぼるだけでも、2017年の平成29年7月九州北部豪雨では土砂災害や洪水により40名の命が奪われ、未曽有の気象災害と呼ばれた2018年の平成30年7月豪雨は200名以上の犠牲者を出しました。
2020年7月に西日本を襲った豪雨は球磨川を中心とする河川氾濫により80名以上の犠牲者を出しました。
この年の6月、中国南部で200名を超える犠牲者を出した長江の氾濫のきっかけとなった持続的な大雨も、7月の球磨川の豪雨と関連していると考えられています。
このような異常気象が発生するたびに、気象庁は記者会見を開いて警戒を呼び掛け、もともと特別警報の基準であった「50年に1度の雨」という言葉が今でもニュースなどで飛び交います。
けれど、ここまで読んで、「あれっ?」と思う読者がいるのではないでしょうか。過去数年間を見るだけでもこれだけ多くの豪雨が起こっているというのに、「50年に1度しか起こらない」という表現は矛盾しているように感じます。
観測データが足りなくても
「50年に1度」は計算できる
では、この「50年に1度」という確率はどのように算出されているのでしょうか?
気象庁では、地域気象観測システム「アメダス」による地点観測データを数十年にわたって蓄積しています。
ある地点で大雨が発生したとき、その地点を代表する観測地点の降水データを観測開始からすべて持ってきて、各年の最大降雨量をまず求めます。その値は当然、年によって上下します。
そのデータを100年分集められたとしましょう。その中の最大雨量というのは、100年に1度程度しか起こらない大雨、上から2番目の値は、その上にもう1つデータがあるので、100年に2回、つまり50年に1度程度しか起こらない大雨ということになります。
しかし、ここで問題が生じます。100年のデータで最大雨量となった値は、500年までデータサンプルを増やしても、やはり最大値となるかもしれません。
つまり、100年に1度ではなく500年に1度レベルの大雨なのかもしれません。つまり、トップに近づけば近づくほど、この誤差は大きくなっていくのです。
逆に、観測開始の年が遅かったために、50年分ものデータを集められない観測地点もあります。そのような地点では、50年に1度の大雨は評価できないことになってしまいます。
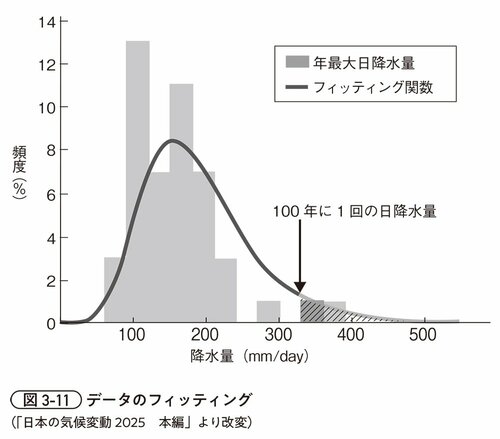
これらの問題に対処するため、気象庁では、得られた数十年分のデータをヒストグラム(ある値を観測する回数を棒グラフにした分布図)にして、データの少ない右端の部分、すなわち最大雨量付近のヒストグラムの形を、全体の形から推定するという方法を取っています。
これを、ここではフィッティングと呼びます。図3-11にその模式図を示します。
 同書より転載 拡大画像表示